Sortowanie topologiczne
Porządek grafu acyklicznego.
Teoria
Sortowanie topologiczne
Motywacja
Wyobraźmy sobie fabrykę samochodów. Wyprodukowanie jednego auta wymaga wykonania setek różnych czynności, których nie możemy realizować w dowolnej kolejności.
Na przykład, zanim zamontujemy silnik, musimy najpierw przygotować ramę samochodu. Podobnie, zanim zamontujemy koła, musimy zamocować zawieszenie. Z kolei montaż przednich i tylnych świateł nie musi odbywać się w ustalonej kolejności.
Dodatkowo wyobraźmy sobie, że istnieje jeden pracownik fabryki, który może wykonywać tylko jedną czynność w danym momencie. Wtedy chcemy znaleźć kolejność wykonywania czynności jedna po drugiej, która spełnia wszystkie zależności.
Jak to zapisać?
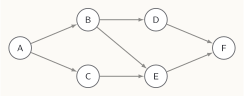
Przedstawmy nasz problem jako graf skierowany. Każdy wierzchołek oznacza jedną czynność. Krawędź oznacza, że czynność musimy wykonać przed czynnością , choć niekoniecznie bezpośrednio przed nią (zobacz Rysunek 1).
Szukamy więc takiej kolejności wszystkich wierzchołków, w której każdy wierzchołek występuje dokładnie raz, a dla każdej krawędzi wierzchołek znajduje się przed . Taką kolejność nazywamy porządkiem topologicznym.
W kolejnych sekcjach poznamy algorytm wyznaczający porządek topologiczny i przekonamy się, jaki związek ma jego istnienie z cyklami skierowanymi w grafie.
Idea algorytmu
Każdy porządek topologiczny to ciąg wierzchołków zapisanych od lewej do prawej tak, że wszystkie krawędzie są skierowane w prawo (zobacz Rysunek 2).
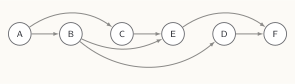
Jaki wierzchołek może być pierwszym w porządku topologicznym? Taki, do którego nie wchodzi żadna krawędź. Innymi słowy, ma stopień wchodzący . W naszym przykładzie jedynym takim wierzchołkiem jest .
A co, jeśli nie istnieje wierzchołek o stopniu wchodzącym ? Wtedy każda czynność wymaga wcześniejszego wykonania innej czynności. Zatem nie możemy zacząć wykonywać żadnej czynności, a więc nie istnieje porządek topologiczny. To uzasadnia następującą obserwację:
Co więcej, każdy wierzchołek o stopniu wchodzącym może być pierwszym wierzchołkiem w porządku topologicznym.
Zatem jeśli istnieje porządek topologiczny, to możemy wybrać dowolny wierzchołek o stopniu wchodzącym i umieścić go na początku naszego rozwiązania — w naszym przykładzie musimy wybrać .
Mamy już połowę naszego algorytmu. Teraz, po wybraniu jako pierwszego wierzchołka naszego rozwiązania, możemy go usunąć z grafu. Po usunięciu usuwamy również krawędzie i . Po usunięciu pierwszego wierzchołka pozostaje nam dokładnie taki sam problem, tylko dla mniejszego grafu. Teraz zarówno , jak i mają stopień wchodzący , więc możemy wybrać dowolny z nich. Wybierzmy . Po jego usunięciu dostępny staje się również . Natomiast nadal musi poczekać, ponieważ pozostaje krawędź .
Za każdym razem wybieramy wierzchołek, którego wszyscy poprzednicy zostali już dodani do wyniku. Dzięki temu każda czynność pojawia się dopiero po wszystkich czynnościach, od których zależy. Jeśli w ten sposób zapiszemy wszystkie wierzchołki, każda zależność będzie spełniona.
Jeśli w którymś momencie działania algorytmu zostały jeszcze wierzchołki, ale żaden z nich nie ma stopnia wchodzącego , nie możemy wybrać następnego. Każdy wymaga wcześniejszego wybrania któregoś z pozostałych wierzchołków. Nie da się więc uporządkować pozostałej części, a tym samym całego grafu.
Nasz algorytm jest więc prosty: wybieramy dowolny wierzchołek o stopniu wchodzącym , dopisujemy go do wyniku i usuwamy z grafu. Powtarzamy te kroki, dopóki możemy. Jeśli usuniemy wszystkie wierzchołki, otrzymamy porządek topologiczny. W przeciwnym razie taki porządek nie istnieje.
Implementacja
Zastanówmy się, jak efektywnie wykonywać kolejne kroki naszego algorytmu:
Znajdź wierzchołek o stopniu wchodzącym .
Usuń go z grafu.
Powtarzaj.
Najpierw przygotujemy tablicę stopni , która dla każdego wierzchołka przechowuje jego stopień wchodzący. Następnie wszystkie wierzchołki o stopniu wchodzącym umieszczamy w kolejce .
To pierwszy etap naszego algorytmu, w którym przygotowujemy tablice i zmienne do dalszych obliczeń. Często nazywamy go preprocessingiem.
Teraz zaczynamy wykonywać właściwą część algorytmu. W każdym kroku wybieramy wierzchołek z kolejki, dodajemy go do naszego rozwiązania i usuwamy go z grafu.
Nie musimy naprawdę usuwać wierzchołków ani krawędzi z list sąsiedztwa. Wystarczy pamiętać, aktualną liczbę krawędzi wchodzących każdego wierzchołka. Tę liczbę przechowuje .
Gdy dopisujemy do wyniku, dla każdej krawędzi zmniejszamy o . Krawędzie odczytujemy z listy sąsiedztwa wierzchołka . Gdy licznik spadnie do , wierzchołek jest gotowy i dodajemy go do kolejki.
Złożoność
Preprocessing, czyli obliczenie tablicy i przygotowanie kolejki , zajmuje czas , gdzie to liczba wierzchołków, a to liczba krawędzi w grafie.
W głównej części algorytmu każdy wierzchołek trafia do kolejki co najwyżej raz. Gdy go przetwarzamy, przeglądamy tylko krawędzie, które z niego wychodzą. Każda krawędź zostanie więc rozpatrzona co najwyżej raz. Łącznie daje to czas .
Zatem cały algorytm działa w czasie i wymaga pamięci .
Porządek topologiczny a cykl
Mając już pierwszą intuicję na czym polega porządek topologiczny i jak go policzyć, możemy teraz przejść do wniosków, które możemy wyciągnąć z naszego algorytmu.
Spróbujmy to udowodnić. Po pierwsze łatwo widać, że nie mogą zachodzić naraz obie sytuacje. Faktycznie, jeśli istnieje porządek topologiczny, to nie może istnieć cykl. Nie możemy bowiem uporządkować wierzchołki cyklu w taki sposób, aby wszystkie krawędzie były skierowane w prawo.
Załóżmy zatem, że w grafie nie istnieje cykl. Chcemy pokazać, że zawsze da się znaleźć porządek topologiczny.
Zaczniemy od następującej obserwacji:
Aby ją udowodnić, będziemy “spacerować” po grafie zaczynając w dowolnym wierzchołku . Jeśli ma stopień wchodzący , to już mamy wierzchołek, którego szukamy. W przeciwnym razie wybierzmy dowolną krawędź do tego wierzchołka i przejdźmy nią do wierzchołka, z którego wychodzi. Powtarzamy ten proces, aż znajdziemy wierzchołek o stopniu wchodzącym , zobacz Rysunek 3.
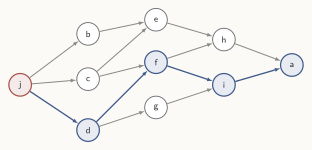
Gdybyśmy odwiedzili ponownie którykolwiek wierzchołek, oznaczałoby to, że przeszliśmy po cyklu skierowanym. Założyliśmy jednak, że taki cykl nie istnieje. Więc, za każdym razem przechodzimy do wierzchołka, który nie był jeszcze odwiedzony. Ponieważ wierzchołków jest skończenie wiele, w końcu musimy dojść do wierzchołka, który nie ma żadnych krawędzi wchodzących. Taki wierzchołek musi mieć stopień wchodzący .
Wróćmy teraz do naszego algorytmu. Pokazaliśmy, że jeśli graf nie zawiera cyklu skierowanego, to zawsze możemy znaleźć wierzchołek o stopniu wchodzącym .
Wracając do naszego dowodu, przypomnijmy, że założylismy, że w grafie nie istnieje cykl. W takim razie możemy znaleźć wierzchołek o stopniu wchodzącym .
Dopisujemy ten wierzchołek do wyniku i usuwamy go z grafu. Ponieważ usuwanie wierzchołków nie może stworzyć cyklu, w pozostałym grafie nadal nie ma cykli skierowanych. Możemy więc powtarzać ten proces, aż usuniemy wszystkie wierzchołki. Otrzymana kolejność jest porządkiem topologicznym.
Dlatego o grafach skierowanych w których istnieje porządek topologiczny możemy powiedzieć, że są acykliczne. Takie grafy nazywami (ang. , w skrócie DAG).
Co dalej
Porządek topologiczny jest bardzo przydatnym narzędziem w wielu problemach algorytmicznych. Pozwala nam na przykład wyznaczyć najkrótsze ścieżki w grafie skierowanym, w którym krawędzie mają nieujemne wagi. Często w zadaniach można się też spotkać z programowaniem dynamicznym na grafach skierowanych, w których porządek topologiczny pozwala nam wyznaczyć kolejność obliczeń.
A w kolejnych lekcjach dowiemy się co możemy zrobić, jeśli w grafie istnieje cykl skierowany, ale mimo to, chcemy wyznaczyć pewien porządek grafu. Nauczyamy się wyznaczać grafu.
Kod C++
#include <iostream>
#include <queue>
#include <vector>
using namespace std;

int main() {
    ios::sync_with_stdio(false);
    cin.tie(nullptr);

    int n, m; int u, v;
    cin >> n >> m;
    vector< vector<int> > adj(n+1);
    for (int i = 1; i <= m; ++i) {
        cin >> u >> v;
        adj[u].push_back(v);
    }

    vector<int> in_deg(n+1, 0);
    for (u = 1; u <= n; ++u) {
        for (int v : adj[u]) {
            in_deg[v]++;
        }
    }

    queue<int> q;
    for (v = 1; v <= n; ++v) {
        if (in_deg[v] == 0) {
            q.push(v);
        }
    }

    vector<int> topo_order;
    while (!q.empty()) {
        u = q.front();
        q.pop();
        topo_order.push_back(u);
        for (int v : adj[u]) {
            --in_deg[v];
            if (in_deg[v] == 0) {
                q.push(v);
            }
        }
    }

    if ( (int)topo_order.size() != n) {
        cout << "CYKL\n";
        return 0;
    }

    for (int v : topo_order) {
        cout << v << " ";
    }
    cout << "\n";
    return 0;
}
input Linie 11–16
Wczytujemy liczbę wierzchołków i liczbę krawędzi . Następnie wczytujemy krawędzi skierowanych i zapisujemy je w liście sąsiedztwa . Wektor zawiera wszystkie wierzchołki , do których prowadzi krawędź z .
degrees Linie 18–23
Najpierw obliczamy stopień wejściowy każdego wierzchołka. W tablicy zapisujemy liczbę krawędzi, które prowadzą bezpośrednio do .
Aby to obliczyć, dla każdej krawędzi odczytanej z listy sąsiedztwa zwiększamy wartość o jeden.
queue Linie 25–30
Do kolejki dodajemy wierzchołki o stopniu wejściowym równym zero. Nie mają one żadnych poprzedników, więc mogą rozpocząć porządek topologiczny.
process Linie 32–43
Dopóki kolejka nie jest pusta:
Wyjmujemy wierzchołek i dopisujemy go do wyniku.
Dla każdej krawędzi zmniejszamy .
Jeśli stopień spadł do zera, dodajemy do kolejki.
Zmniejszanie stopni odpowiada usuwaniu krawędzi wychodzących z przetworzonego wierzchołka.
cycle Linie 45–48
Jeżeli wynik zawiera mniej niż wierzchołków, w grafie istnieje cykl skierowany, zatem wypisujemy CYKL. W przeciwnym razie możemy wypisać znaleziony porządek topologiczny.
output Linie 50–53
Jeżeli graf nie zawiera cyklu, wypisujemy wierzchołki w kolejności topologicznej.